


È Apache Hadoop Big Data Product?
Riepilogo dell’articolo:
Hadoop e l’ecosistema dei big data:
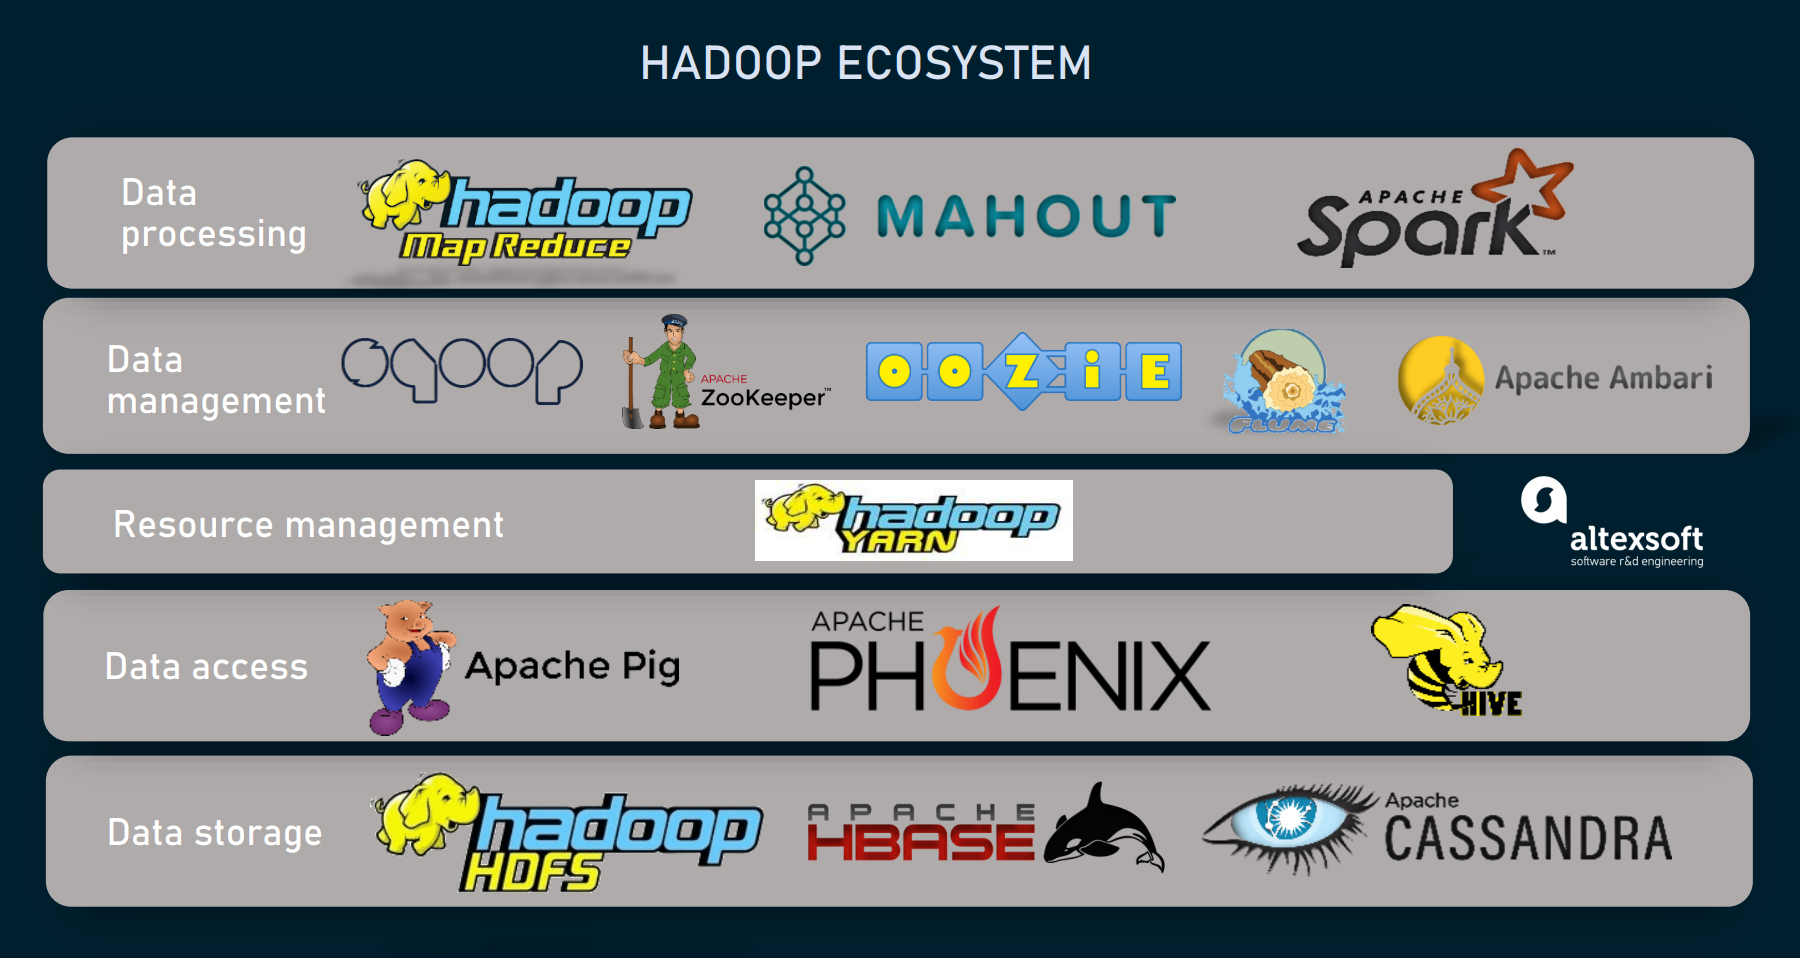
Nel mondo dei big data, Hadoop svolge un ruolo cruciale. Non è un database ma un framework software open source progettato specificamente per gestire grandi volumi di dati strutturati e semi-strutturati. L’ecosistema Hadoop include vari strumenti e applicazioni che aiutano a raccogliere, archiviare, elaborare, analizzare e gestire i big data. Un’applicazione popolare all’interno dell’ecosistema Hadoop è Spark, un sistema di elaborazione distribuito utilizzato per i carichi di lavoro dei big data.
Punti chiave:
- Hadoop non è un database: A differenza dei database tradizionali, Hadoop non è progettato per archiviare e recuperare i dati in modo strutturato. Viene utilizzato principalmente per l’elaborazione e la gestione di grandi volumi di dati.
- Hadoop vs. Apache Spark: Sia Hadoop che Spark sono framework open source per l’elaborazione dei big data. Tuttavia, differiscono nei loro approcci di elaborazione dei dati. Hadoop impiega il modello MapReduce, mentre Spark utilizza set di dati distribuiti resilienti (RDDS).
- Il concetto di big data: I big data si riferiscono a set di dati di dimensioni enormi e non possono essere elaborati efficacemente utilizzando metodi di elaborazione tradizionali. Comprende una vasta gamma di tipi di dati e richiede quadri e strumenti specializzati per l’analisi.
- Differenza tra Hadoop e Big Data: Hadoop è un framework che gestisce ed elabora i big data, mentre i big data stessa rappresentano il grande volume di dati che possono essere strutturati o non strutturati.
- Caratteristiche dei big data: I big data sono caratterizzati dalla sua maggiore varietà, aumentano il volume e una maggiore velocità. Include set di dati grandi e complessi da varie fonti che richiedono tecniche di elaborazione avanzate.
- Hadoop vs. Server SQL: Hadoop e SQL Server differiscono in termini di integrità, funzionalità di scrittura e struttura dello schema. Hadoop ha una bassa integrità, supporta le operazioni di Write-Once e ha una struttura schema dinamica. D’altra parte, SQL Server ha un’alta integrità, supporta più scritture e ha una struttura dello schema statico.
- Apache Spark come piattaforma di big data: Apache Spark è un sistema di elaborazione distribuito open source appositamente progettato per i carichi di lavoro dei big data. Sfrutta la cache in memoria e l’esecuzione delle query ottimizzata per consentire query analitiche rapide su set di dati di qualsiasi dimensione.
Domande:
- Hadoop è considerato una parte dei big data?
- Che tipo di database è Apache Hadoop?
- In che modo Apache Hadoop differisce da Apache Spark?
- Perché Hadoop è associato ai big data?
- Ciò che distingue Hadoop dai big data?
- Come vengono classificati i big data?
- Quali sono le differenze tra Apache Hadoop e SQL Server?
- Apache Spark è considerata una piattaforma di big data?
Sì, Hadoop è parte integrante dei big data in quanto fornisce il framework e gli strumenti per gestire grandi volumi di dati.
Apache Hadoop non è un database ma un framework software progettato per elaborare e gestire grandi volumi di dati strutturati e semi-strutturati.
Apache Hadoop e Apache Spark sono entrambi framework open source per l’elaborazione dei big data, ma differiscono nei loro approcci di elaborazione dei dati. Hadoop impiega il modello MapReduce, mentre Spark utilizza set di dati distribuiti resilienti (RDDS).
Hadoop è spesso collegato ai big data perché fornisce gli strumenti e il framework necessari per gestire ed elaborare grandi volumi di dati che non possono essere gestiti con metodi di calcolo tradizionali.
Hadoop è un framework progettato per gestire ed elaborare i big data, mentre i big data si riferiscono al grande volume di dati strutturati o non strutturati.
I big data sono classificati in base alle sue caratteristiche, che includono maggiore varietà, aumento dei volumi e maggiore velocità di dati. Comprende set di dati grandi e complessi da varie fonti.
Apache Hadoop e SQL Server differiscono in termini di integrità, funzionalità di scrittura e struttura dello schema. Hadoop ha una bassa integrità, supporta le operazioni di Write-Once e ha una struttura schema dinamica. Al contrario, SQL Server ha un’alta integrità, supporta più scritture e ha una struttura dello schema statico.
Sì, Apache Spark è un sistema di elaborazione distribuito ad open source ampiamente utilizzato noto per la sua efficienza nella gestione dei carichi di lavoro dei big data.
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Fa hadoop parte dei big data
Oggi, l’ecosistema Hadoop include molti strumenti e applicazioni per aiutare a raccogliere, archiviare, elaborare, analizzare e gestire i big data. Alcune delle applicazioni più popolari sono: Spark: un sistema di elaborazione distribuito open source comunemente utilizzato per i carichi di lavoro dei big data.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Che tipo di database è Apache Hadoop
È Hadoop Un database Hadoop non è un database, ma piuttosto un framework software open source specificamente creato per gestire grandi volumi di dati strutturati e semi-strutturati.
Cache
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] È apache hadoop diverso da Hadoop
Apache Hadoop e Apache Spark sono entrambi quadri open source per l’elaborazione dei big data con alcune differenze chiave. Hadoop utilizza MapReduce per elaborare i dati, mentre Spark utilizza set di dati distribuiti resilienti (RDD).
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Perché Hadoop è chiamato big data
Big Data specifica set di dati molto grandi. È un tesoro di set di dati di grandi dimensioni che non possono essere elaborati dai tradizionali metodi di calcolo. I big data sono correlati a un soggetto completo piuttosto che semplicemente dati che possono essere elaborati utilizzando varie tecniche, strumenti e framework.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Qual è la differenza tra Hadoop e Big Data
Definizione: Hadoop è una sorta di framework in grado di gestire l’enorme volume di big data ed elaborarli, mentre i big data sono solo un grande volume dei dati che possono essere in dati non strutturati e strutturati.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Ciò che è classificato come big data
Ciò che è esattamente big data la definizione di big data sono i dati che contengono una maggiore varietà, arrivando in aumento dei volumi e con maggiore velocità. Questo è anche noto come i tre Vs. In parole povere, i big data sono set di dati più grandi e complessi, soprattutto da nuove fonti di dati.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] In che modo Apache Hadoop è diverso da SQL Server
Hadoop è una bassa integrità; SQL è alta integrità. Hadoop può scrivere solo una volta; SQL scrive più volte. Hadoop ha una struttura schema dinamica; SQL ha una struttura dello schema statico. Hadoop supporta l’elaborazione batch (tramite HDFS); SQL no.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Apache Spark è una piattaforma di big data
Apache Spark è un sistema di elaborazione distribuito open source utilizzato per i carichi di lavoro dei big data. Utilizza la memorizzazione in memoria e l’esecuzione delle query ottimizzata per query analitiche rapide rispetto ai dati di qualsiasi dimensione.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Quali sono i 2 tipi di Hadoop
Tipi di ClusterShadoop di Hadoop.Big-Data.Riduci mappa.bigdata.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Cos’è big data apache scintalia vs hadoop
Hadoop è il fondamento della tua architettura dei big data. È responsabile della memorizzazione e dell’elaborazione dei dati. Spark è un motore di elaborazione in memoria in grado di eseguire l’elaborazione del flusso in tempo reale o l’elaborazione batch sui dati memorizzati in Hadoop.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Qual è la differenza tra big data e Hadoop
I big data non sono uno strumento ma Hadoop è uno strumento. I big data sono trattati come una risorsa, che può essere preziosa, mentre Hadoop è trattato come un programma per ottenere il valore dall’asset, che è la differenza principale tra Big Data e Hadoop.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Cos’è big data apache scintalia vs hadoop
Hadoop è il fondamento della tua architettura dei big data. È responsabile della memorizzazione e dell’elaborazione dei dati. Spark è un motore di elaborazione in memoria in grado di eseguire l’elaborazione del flusso in tempo reale o l’elaborazione batch sui dati memorizzati in Hadoop.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Quali sono i 3 tipi di big data
La classificazione dei big data è divisa in tre parti, come dati strutturati, dati non strutturati e dati semi-strutturati.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Quali sono esempi di dati sui big data
Quali sono gli esempi di big data big data provengono da una miriade di fonti: alcuni esempi sono sistemi di elaborazione delle transazioni, database dei clienti, documenti, e -mail, cartelle cliniche, registri clickstream Internet, app mobili e social network.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Quali sono i due componenti principali di Apache Hadoop
HDFS (archiviazione) e filato (elaborazione) sono i due componenti principali di Apache Hadoop.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] È Hadoop un database SQL
Hadoop e SQL gestiscono entrambi i dati, ma in modi diversi. Hadoop è un framework di componenti software, mentre SQL è un linguaggio di programmazione. Per i big data, entrambi gli strumenti hanno pro e contro. Hadoop gestisce set di dati più grandi ma scrive dati solo una volta.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Cos’è Big Data Hadoop vs Spark
Spark ha la sua libreria di apprendimento automatico chiamato MLIB, mentre Hadoop deve essere interfacciato con una libreria di apprendimento automatico esterno, ad esempio Apache Mahout. Poiché Spark è più veloce di Hadoop, è ben in grado di gestire operazioni di analisi avanzata come l’elaborazione dei dati in tempo reale rispetto a Hadoop.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Qual è la differenza tra big data e Hadoop
Definizione: Hadoop è una sorta di framework in grado di gestire l’enorme volume di big data ed elaborarli, mentre i big data sono solo un grande volume dei dati che possono essere in dati non strutturati e strutturati.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Apache Spark è una piattaforma di big data
Apache Spark è un sistema di elaborazione distribuito open source utilizzato per i carichi di lavoro dei big data. Utilizza la memorizzazione in memoria e l’esecuzione delle query ottimizzata per query analitiche rapide rispetto ai dati di qualsiasi dimensione.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Quali sono le 3 principali differenze tra Hadoop e Spark
Hadoop gestisce in modo efficiente l’elaborazione batch, mentre Spark eccelle nella gestione dei dati in tempo reale. Hadoop è un framework di calcolo ad alta latenza, che non ha una modalità interattiva, mentre Spark è un calcolo a bassa latenza e può elaborare i dati in modo interattivo.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Che sono i tre tipi di dati in Hadoop
Gli HDF di Hadoop possono archiviare diversi formati di dati, come strutturati, semi-strutturati e non strutturati.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Big Data e Hadoop richiedono la codifica
Hadoop richiede la conoscenza di diversi linguaggi di programmazione, a seconda del ruolo che si desidera svolgere. Ad esempio, R o Python sono rilevanti per l’analisi, mentre Java è più rilevante per il lavoro di sviluppo.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Quali sono i 5 big data
Big Data è una raccolta di dati da molte fonti diverse ed è spesso descritto per cinque caratteristiche: volume, valore, varietà, velocità e veracità.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Quali sono due esempi di big data
9 esempi di big data & Usa Casestransportation.Pubblicità e Marketing.Servizi bancari e finanziari.Governo.Media e intrattenimento.Meteorologia.Assistenza sanitaria.Sicurezza informatica.
[/WPREMARK]
[wppremark_icon icon = “quote-left-2-solid” width = ” 32 “altezza =” 32 “] Quali sono i grandi 5 dei big data
Big Data è una raccolta di dati da molte fonti diverse ed è spesso descritto per cinque caratteristiche: volume, valore, varietà, velocità e veracità.
[/WPREMARK]